Une panne de serveur, un poste devenu instable ou un équipement réseau défaillant peuvent interrompre l’activité d’une PME pendant plusieurs heures. Pourtant, multiplier les visites techniques et les contrôles systématiques ne garantit pas une meilleure disponibilité informatique. Certaines interventions mobilisent inutilement le support, tandis que des équipements réellement critiques restent insuffisamment surveillés.
Une maintenance informatique préventive efficace consiste à effectuer les bons contrôles, sur les bons équipements, au moment où ils apportent une valeur réelle. Elle combine un calendrier réaliste, une surveillance adaptée aux risques, des mises à jour maîtrisées et une anticipation du remplacement du matériel.
L’objectif n’est donc pas d’entretenir chaque ordinateur à intervalles identiques, mais de réduire les interruptions sans augmenter inutilement les coûts de maintenance. Pour une PME disposant de ressources techniques limitées, cette organisation repose sur quelques décisions documentées : identifier les équipements indispensables, distinguer les interventions nécessaires des contrôles facultatifs et adapter les fréquences aux incidents réellement observés.
Maintenance préventive : les trois principes essentiels
- Prioriser selon les risques : surveiller d’abord les équipements dont la panne compromet l’activité de plusieurs collaborateurs ou des services essentiels.
- Regrouper les interventions : construire un calendrier commun, exploiter les fenêtres de maintenance et éviter les contrôles répétitifs sans utilité démontrée.
- Adapter les décisions à l’état réel : renforcer la surveillance lorsqu’une dégradation apparaît et anticiper le remplacement lorsque la maintenance devient moins pertinente.
- Pourquoi attendre la panne rend-il la maintenance informatique plus coûteuse ?
- Comment construire un calendrier de maintenance pour postes, serveurs et équipements réseau ?
- Quels matériels informatiques surveiller en priorité quand les ressources de support sont limitées ?
- Comment éviter qu’une opération de maintenance perturbe toute une équipe ?
- Quand augmenter la fréquence de maintenance d’un équipement vieillissant ?
- Comment tester une mise à jour avant de l’installer sur tous les postes de l’entreprise ?
- Quels signes indiquent qu’un équipement fonctionnel est arrivé en fin de vie ?
- Comment gérer le cycle de vie des équipements informatiques sans attendre les pannes ?
Pourquoi attendre la panne rend-il la maintenance informatique plus coûteuse ?
Attendre qu’un équipement informatique tombe en panne coûte souvent davantage qu’un contrôle préventif ciblé, car la réparation n’est qu’une partie de la dépense. Il faut également compter l’interruption des collaborateurs, les conséquences sur l’activité et la mobilisation urgente du support. La prévention devient rentable lorsqu’elle réduit ces risques sans multiplier les opérations inutiles.
Une panne non planifiée entraîne trois catégories de coûts :
- Le coût direct : diagnostic, réparation, remplacement de composants et éventuelle intervention d’un prestataire.
- Le coût d’interruption : collaborateurs immobilisés, dossiers retardés, applications indisponibles ou commandes impossibles à traiter.
- Le coût de l’urgence : déplacements imprévus, recherche de pièces disponibles et réorganisation des priorités du support.
Ces coûts peuvent s’additionner. Lorsqu’un serveur de fichiers devient indisponible, la réparation technique ne représente qu’une partie des conséquences : les collaborateurs dépendant des documents partagés peuvent également être ralentis ou bloqués.
Une défaillance négligée peut aussi déclencher une succession d’incidents. Par exemple, un disque de serveur présentant des erreurs répétées peut dégrader les temps d’accès, provoquer des interruptions applicatives et entraîner plusieurs demandes de support. Une alerte correctement analysée aurait parfois permis de planifier une seule opération de remplacement.
Pour autant, tous les incidents ne sont pas prévisibles. Certaines pannes électroniques surviennent sans signe exploitable. Dans ces situations, la disponibilité dépend davantage de la redondance, des sauvegardes et de la capacité de remplacement que d’une multiplication des inspections.
Cette distinction rejoint les principes présentés dans la présentation du Department of Energy sur les stratégies de maintenance. L’organisme distingue maintenance corrective, préventive, prédictive et maintenance centrée sur la fiabilité. Ces approches générales peuvent éclairer les choix informatiques, sans fournir de fréquence universelle pour les équipements d’une PME.
La prévention excessive constitue l’autre risque économique : vérifier chaque semaine un poste stable et peu critique peut mobiliser du temps sans réduire sensiblement la probabilité d’une panne.
La bonne approche consiste à comparer le coût probable d’une défaillance avec celui des actions capables d’en réduire le risque. Cette logique sert ensuite à construire un calendrier proportionné aux besoins de l’entreprise.
Comment construire un calendrier de maintenance pour postes, serveurs et équipements réseau ?
Un calendrier de maintenance informatique efficace se construit en classant les opérations selon leur nécessité, la criticité des équipements et les risques réellement observés. Il doit prévoir les sauvegardes, les mises à jour de sécurité et les contrôles utiles, puis regrouper les interventions compatibles. Les fréquences doivent rester ajustables plutôt que figées indépendamment de l’état du parc.
La première étape consiste à inventorier les postes, serveurs, équipements réseau et systèmes de protection électrique. Chaque famille doit être associée aux services qu’elle fournit et aux conséquences prévisibles d’une indisponibilité.
Le planning peut ensuite être organisé en trois niveaux :
- Les tâches indispensables : vérification de l’exécution des sauvegardes, tests de restauration planifiés, traitement des correctifs de sécurité et contrôle des alertes critiques.
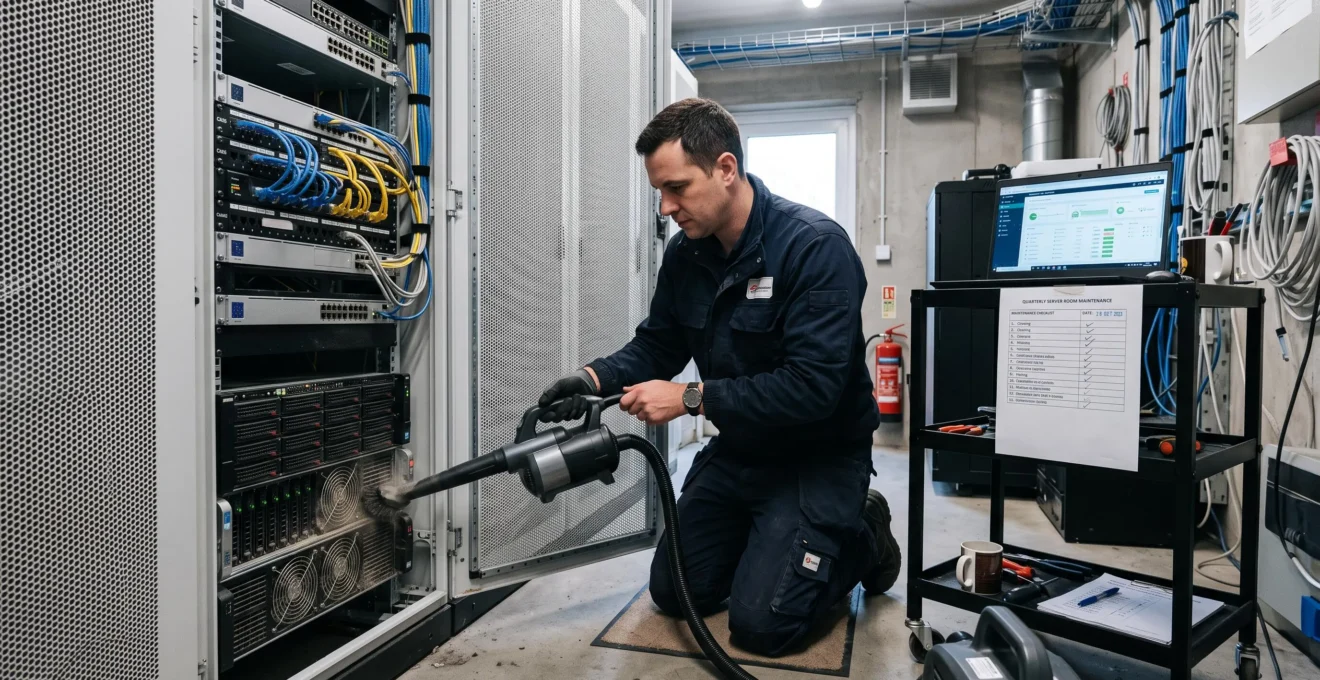
- Les tâches liées à l’utilisation : nettoyage des ventilations selon l’empoussièrement, contrôle des périphériques sollicités ou vérifications adaptées aux conditions d’exploitation.
- Les tâches déclenchées par l’état : examen approfondi d’un disque signalant des erreurs, diagnostic d’une batterie d’onduleur dégradée ou surveillance renforcée d’un équipement instable.
Le Guide d’hygiène informatique de l’ANSSI recommande notamment de formaliser une politique de mise à jour, de surveiller les composants critiques et de définir les fréquences de sauvegarde ainsi que les modalités de test de restauration. Ces recommandations constituent un socle de sécurité, sans imposer une périodicité identique à tous les matériels.
Pour éviter de mobiliser les équipes à répétition, les opérations compatibles peuvent être regroupées par site, type d’équipement ou période de faible activité. Une fenêtre commune peut, par exemple, servir à contrôler plusieurs postes d’un même service sans organiser une interruption distincte pour chaque machine.
Pour déterminer la fréquence des vérifications, trois questions doivent guider la décision : quelle est la criticité métier de l’équipement, quel serait l’impact de sa panne et combien coûte le contrôle envisagé ? Cette grille qualitative aide à comparer les priorités sans prétendre calculer automatiquement une fréquence optimale.
| Équipement | Priorité de surveillance | Organisation adaptée |
|---|---|---|
| Serveur hébergeant une application essentielle | Élevée en raison du risque d’interruption collective | Supervision continue si disponible, traitement des alertes et interventions programmées |
| Postes bureautiques standards | Variable selon les utilisateurs et les applications | Mises à jour centralisées et contrôles regroupés par lots |
| Commutateur réseau principal | Élevée lorsqu’il dessert plusieurs services | Surveillance des alertes, sauvegarde de configuration et créneaux coordonnés |
| Imprimante secondaire | Faible si une solution de remplacement existe | Entretien selon l’usage, les alertes et les préconisations du fabricant |
Ces priorités sont indicatives : la disponibilité d’un équipement de secours et les contraintes métier peuvent modifier les arbitrages. Un contrôle n’est utile que s’il permet de détecter un risque ou d’engager une action pertinente.
Checklist : mettre en place un planning de maintenance exploitable
- Recenser les équipements : créer un inventaire indiquant leur emplacement, leur fonction et leur responsable technique. Livrable : une liste de parc actualisée.
- Classer les risques : attribuer à chaque équipement une criticité métier et identifier ses principales dépendances. Livrable : une matrice de priorisation.
- Définir les contrôles : préciser la tâche, son déclencheur ou sa fréquence, et le résultat attendu. Livrable : un tableau des opérations préventives.
- Regrouper les interventions : réserver des créneaux compatibles avec l’activité et les contraintes des utilisateurs. Livrable : un calendrier partagé.
- Contrôler l’exécution : enregistrer les opérations réalisées, les anomalies et les tâches devenues superflues. Livrable : un compte rendu de revue périodique.
Un calendrier jamais vérifié risque de donner une impression trompeuse de maîtrise. Lors de chaque revue, comparer les interventions prévues aux opérations réellement effectuées permet d’identifier les contrôles oubliés, redondants ou devenus inutiles.
Le planning constitue ainsi un outil de décision, pas simplement une succession de rendez-vous techniques. Son efficacité dépend surtout de la capacité à concentrer l’effort sur les équipements qui justifient réellement une surveillance.
Quels matériels informatiques surveiller en priorité quand les ressources de support sont limitées ?
Quand le temps de support est limité, les équipements à surveiller en priorité sont ceux dont la défaillance bloquerait plusieurs collaborateurs, compromettrait des données essentielles ou interromprait un service métier. La criticité de l’activité doit passer avant l’ancienneté du matériel. Un serveur récent mais indispensable peut ainsi nécessiter davantage d’attention qu’un ordinateur ancien et facilement remplaçable.
Cette hiérarchisation commence par l’identification des dépendances. Une PME doit notamment examiner les serveurs, les équipements réseau centraux, les systèmes de sauvegarde, les onduleurs et les postes associés à des fonctions indispensables.
La surveillance doit ensuite être adaptée au comportement des composants.
- Dégradations progressives : erreurs de disque, baisse de capacité d’une batterie, ventilation défectueuse ou températures anormales peuvent fournir des indicateurs exploitables avant une défaillance.
- Pannes difficilement prévisibles : certaines alimentations électriques ou cartes électroniques peuvent cesser de fonctionner sans symptôme préalable suffisamment fiable.
- Défaillances liées à la configuration : saturation du stockage, certificats expirés ou services mal configurés peuvent être anticipés grâce à des alertes et à un suivi approprié.
Les premiers cas justifient une supervision ciblée. Pour les pannes aléatoires, la priorité devient souvent la continuité d’activité : équipement de secours, configuration sauvegardée, redondance lorsque nécessaire et procédure de remplacement.
Une distinction importante concerne les sauvegardes. Leur réussite technique ne suffit pas à garantir la récupération des données : des tests de restauration doivent également être prévus selon les besoins de l’entreprise.
Pour arbitrer les demandes, le responsable informatique peut estimer le coût d’un contrôle en temps de support et le comparer à l’impact plausible d’une indisponibilité. Il faut également considérer la capacité du contrôle à révéler une anomalie exploitable. Une surveillance coûteuse qui ne permet aucune action préventive apporte peu de valeur.
Cas pratique hypothétique : choisir entre deux équipements
Une PME dispose d’un serveur de fichiers partagé présentant des alertes de stockage et d’un poste bureautique ancien qui fonctionne normalement. Le support ne peut réaliser qu’un diagnostic approfondi dans le créneau disponible.
La priorité revient au serveur : il présente un signal observable et son indisponibilité pourrait toucher plusieurs collaborateurs. Le poste ancien reste inscrit à l’inventaire et fait l’objet d’un suivi normal, sans intervention supplémentaire justifiée par son âge seul.
La décision doit être tracée dans un registre simple : équipement concerné, risque identifié, action retenue et justification. Ce suivi aide à répondre aux demandes d’intervention sans céder systématiquement à l’urgence perçue.
Une fois ces priorités définies, il reste à organiser les opérations nécessaires sans transformer chaque intervention préventive en interruption collective du travail.
Comment éviter qu’une opération de maintenance perturbe toute une équipe ?
Pour éviter qu’une maintenance informatique désorganise une équipe, il faut identifier les services dépendants de l’équipement, choisir un créneau compatible avec l’activité et préparer une solution de continuité. Chaque intervention doit préciser son périmètre, sa durée prévue, les personnes concernées et les conditions de retour arrière. Le risque opérationnel doit être évalué avant toute modification.
Une intervention apparemment mineure peut avoir des conséquences importantes. Le redémarrage d’un équipement réseau peut, par exemple, interrompre simultanément l’accès à des applications, à des fichiers partagés ou à la téléphonie IP.
Avant de confirmer une opération, le support doit donc répondre à plusieurs questions : qui utilise l’équipement, quelles applications en dépendent, quelles données sont concernées et quelles fonctions resteront accessibles pendant l’interruption ?
Cette qualification permet de distinguer les opérations sans interruption prévisible, celles nécessitant une fenêtre de maintenance et celles qui exigent une préparation particulière.
La fenêtre de maintenance doit être concertée avec les équipes concernées. Un créneau en dehors des horaires habituels peut réduire la gêne, mais il ne convient pas nécessairement aux entreprises ayant des traitements nocturnes, des sauvegardes planifiées ou des activités réparties sur plusieurs fuseaux horaires.
L’annonce doit préciser les services potentiellement indisponibles, les conséquences pour les collaborateurs et les possibilités de fonctionnement temporaire. Les utilisateurs doivent également savoir comment signaler une anomalie après l’intervention.
Un plan de retour arrière complète cette préparation. Il peut comprendre une sauvegarde de configuration, une version précédente conservée, les commandes nécessaires pour restaurer un service et un responsable habilité à décider de l’annulation. La faisabilité du retour arrière doit être vérifiée avant le changement.
Enfin, toutes les opérations ne peuvent pas attendre une période creuse. Une vulnérabilité activement exploitée, une défaillance imminente d’un système critique ou un risque sérieux de perte de données peuvent justifier une intervention rapide. À l’inverse, un nettoyage non urgent ou une amélioration de confort peuvent être reportés lorsque leur réalisation immédiate perturberait davantage l’activité.
Une maintenance bien coordonnée protège la disponibilité du système tout en respectant les contraintes des utilisateurs. Cette organisation devient particulièrement importante lorsque l’état d’un équipement vieillissant impose des interventions plus rapprochées.
Quand augmenter la fréquence de maintenance d’un équipement vieillissant ?
La fréquence de maintenance d’un équipement vieillissant doit augmenter lorsque des indicateurs montrent une dégradation observable et qu’un contrôle supplémentaire peut réellement prévenir une panne. L’âge ne suffit pas à justifier cette décision. Si les interventions deviennent coûteuses ou que la défaillance reste imprévisible, préparer le remplacement peut être plus efficace que renforcer les inspections.
Pour détecter une évolution préoccupante, il faut comparer les mesures et les incidents dans le temps plutôt que se fier à une impression de vétusté.
Les principaux déclencheurs comprennent :
- Une augmentation des incidents mineurs ou des redémarrages imprévus.
- Des temps de traitement qui s’allongent à charge de travail comparable.
- Des alertes récurrentes concernant les disques, les ventilateurs ou les batteries.
- Une hausse anormale des températures ou de la consommation électrique, après vérification des conditions d’utilisation.
- Un besoin croissant d’interventions pour maintenir un niveau de service acceptable.
Ces signaux doivent être contextualisés. Une baisse de performances peut provenir d’un logiciel, d’une configuration ou d’une augmentation de charge, sans démontrer une dégradation matérielle.
Lorsqu’une anomalie est confirmée, un contrôle plus fréquent peut être pertinent pendant une période d’observation. Par exemple, le suivi rapproché des alertes d’un disque peut aider à organiser son remplacement. Il ne doit cependant pas remplacer la sécurisation des données ni être considéré comme une garantie contre une panne soudaine.
Pour choisir entre surveillance renforcée et retrait anticipé, un test en trois questions est utile :
- L’équipement reste-t-il suffisamment critique pour justifier une surveillance supplémentaire ?
- Sa dégradation est-elle mesurable et permet-elle une action préventive concrète ?
- Le surcoût du maintien en service reste-t-il acceptable par rapport au risque de panne et au coût d’un remplacement ?
Lorsque les trois réponses sont positives, une intensification temporaire et encadrée peut se justifier. Dans le cas contraire, il faut réexaminer la stratégie : remplacement, réduction de l’exposition au risque, installation d’une solution de secours ou maintien sous surveillance ordinaire si les conséquences d’une panne sont faibles.
La fréquence doit également être réévaluée après chaque intervention. Si une anomalie a disparu durablement, maintenir indéfiniment des vérifications rapprochées risque de créer une charge inutile.
Cette adaptation progressive évite de consacrer trop de ressources à des équipements déjà proches de leur remplacement. Elle doit aussi tenir compte des risques introduits par les interventions logicielles, notamment les mises à jour déployées sur plusieurs postes.
Comment tester une mise à jour avant de l’installer sur tous les postes de l’entreprise ?
Une mise à jour informatique doit être testée sur un groupe pilote représentatif avant son déploiement général, sauf lorsqu’un risque de sécurité impose un traitement plus rapide. Le test vérifie la compatibilité des logiciels métier, la stabilité des postes et les possibilités de restauration. Le déploiement est ensuite étendu progressivement, avec des critères de validation définis à l’avance.
Une mise à jour défectueuse installée simultanément sur tous les postes peut provoquer une panne collective. Le problème peut toucher un pilote matériel, une application essentielle, un mécanisme d’authentification ou une fonctionnalité utilisée quotidiennement.
Pour limiter ce risque, la démarche doit suivre plusieurs phases.
- Préparer le pilote : sélectionner des postes représentatifs des configurations, périphériques et logiciels effectivement utilisés.
- Définir les tests : vérifier le démarrage, l’authentification, la connexion réseau, les applications métier et les fonctions particulières du poste.
- Observer les résultats : prévoir une période de validation adaptée au type de mise à jour, relever les incidents et recueillir les retours des utilisateurs.
- Élargir progressivement : déployer sur un groupe intermédiaire avant de généraliser aux autres postes compatibles.
- Contrôler la stabilisation : confirmer la réussite des installations et traiter les anomalies avant de clôturer l’opération.
La documentation Microsoft sur le plan de déploiement des mises à jour décrit notamment une organisation en groupes successifs, avec des phases de prévisualisation, de validation sur des appareils représentatifs et de déploiement général. Cette méthode concerne les environnements Windows documentés par Microsoft ; elle doit être adaptée pour les autres systèmes et logiciels.
Le retour arrière représente une condition importante de la préparation. Selon la technologie concernée, il peut reposer sur une sauvegarde vérifiée, une image système, un mécanisme de restauration ou une procédure de désinstallation. La disponibilité réelle de ces mécanismes doit être contrôlée avant de commencer : toutes les mises à jour ne sont pas réversibles de la même manière.
Les correctifs de sécurité urgents demandent un arbitrage particulier. Lorsqu’une vulnérabilité présente un risque élevé, notamment en cas d’exploitation active, attendre l’ensemble des tests habituels peut accroître l’exposition de l’entreprise. Un pilote accéléré, des mesures compensatoires ou un déploiement prioritaire sur les équipements exposés peuvent alors être plus adaptés.
Cette exception doit être justifiée et tracée, avec une surveillance renforcée après installation. La rapidité ne dispense pas de préparer la récupération des services en cas de problème.
Une mise à jour réussie ne suffit toutefois pas à maintenir indéfiniment un équipement en service. La compatibilité et la disponibilité du support technique doivent également entrer dans les décisions de maintenance.
Quels signes indiquent qu’un équipement fonctionnel est arrivé en fin de vie ?
Un équipement informatique peut atteindre sa fin de vie économique ou technique tout en continuant à fonctionner. Les signes déterminants sont l’augmentation des interventions, la difficulté à trouver des pièces, la perte de compatibilité et surtout l’absence de correctifs de sécurité nécessaires. Le remplacement doit être envisagé lorsque les risques et les coûts de maintien deviennent moins acceptables que ceux d’une migration planifiée.
Il faut distinguer la fin de vie fonctionnelle, qui correspond à l’incapacité de répondre au besoin, de la fin de vie économique, lorsque le maintien en service n’est plus pertinent au regard des coûts et des risques.
Trois familles de signaux facilitent cette évaluation.
| Nature du signal | Exemples observables | Décision à examiner |
|---|---|---|
| Technique | Surchauffe répétée, erreurs matérielles, redémarrages, ralentissements persistants | Diagnostic approfondi, réparation ciblée ou préparation du remplacement |
| Économique | Interventions récurrentes, pièces difficiles à obtenir, coûts de fonctionnement élevés | Comparaison entre maintien en service et renouvellement |
| Obsolescence | Fin de support, absence de correctifs, incompatibilité avec des logiciels nécessaires | Migration, remplacement ou mesures temporaires de réduction du risque |
La fin du support logiciel mérite une attention particulière. Un ordinateur peut encore démarrer normalement alors que son système d’exploitation ne bénéficie plus des mises à jour de sécurité nécessaires. Son bon fonctionnement apparent ne garantit donc pas qu’il reste approprié pour un usage professionnel connecté.
Pour les systèmes Windows, la documentation officielle de Microsoft sur le cycle de vie précise les conséquences de la fin du support et rappelle qu’un produit peut continuer à fonctionner sans recevoir les mêmes services de maintenance. Les échéances doivent être vérifiées selon la version et l’édition réellement installées.
La décision économique doit tenir compte du cumul des interventions, du coût prévisible des prochaines réparations, des interruptions et de l’investissement nécessaire à la migration. Aucun seuil de dépense universel ne permet de décider automatiquement du remplacement de tous les matériels.
Il faut également éviter l’excès inverse : un ordinateur ancien, stable, compatible avec les besoins et correctement sécurisé peut rester utile. Si son indisponibilité aurait peu de conséquences et qu’il dispose d’une solution de remplacement, son renouvellement immédiat n’est pas forcément justifié.
En revanche, conserver un équipement dont le logiciel indispensable n’est plus pris en charge exige une analyse de sécurité spécifique. L’isolement temporaire peut réduire certains risques, mais il ne constitue pas nécessairement une solution durable.
Ces indicateurs doivent alimenter un suivi continu du parc. Ils permettent de préparer les investissements et les migrations plutôt que de découvrir les besoins de remplacement au moment d’une panne.
À retenir avant de piloter le renouvellement du parc
- Une décision de remplacement doit tenir compte à la fois de la criticité métier, de l’état du matériel et de sa prise en charge logicielle.
- Le temps consacré aux réparations récurrentes doit être comparé au coût global d’une migration anticipée, pas seulement au prix d’achat du nouvel équipement.
- Un inventaire actualisé permet de coordonner maintenance, budget, sécurité et retrait des anciens matériels sans déclencher d’interventions superflues.
Comment gérer le cycle de vie des équipements informatiques sans attendre les pannes ?
La gestion du cycle de vie informatique consiste à suivre chaque équipement depuis son acquisition jusqu’à son retrait, afin d’adapter la maintenance et d’anticiper son remplacement. Pour une PME, un inventaire enrichi de quelques informations suffit à structurer cette démarche : criticité, date d’installation, incidents, état de support et statut de renouvellement. Les décisions deviennent ainsi prévisibles plutôt qu’urgentes.
Le cycle de vie comprend plusieurs étapes complémentaires : acquisition et configuration, exploitation, maintenance adaptée à l’état du matériel, décision de renouvellement, migration et retrait sécurisé.
À l’acquisition, il est utile de documenter la fonction de l’équipement, ses principales caractéristiques, les garanties applicables, les licences associées et les conditions de support. Ces informations facilitent ensuite les diagnostics et les décisions de remplacement.
Pendant l’exploitation, une fiche de suivi peut regrouper les éléments nécessaires aux arbitrages :
- L’identifiant de l’équipement, son modèle et son emplacement.
- Sa date de mise en service et les informations de garantie ou de support disponibles.
- Les services métier dépendants et son niveau de criticité.
- Les incidents, interventions et anomalies récurrentes.
- Son statut : en service, à surveiller, remplacement prévu ou en fin de vie.
- La prochaine décision ou vérification attendue, avec un responsable identifié.
Un tableur partagé et correctement administré peut suffire pour un petit parc. Lorsque le nombre d’équipements augmente, un outil d’inventaire ou de gestion des actifs informatiques peut faciliter l’actualisation des informations, sans remplacer la validation humaine des décisions.
Le renouvellement doit ensuite être intégré aux prévisions budgétaires. Commander avant une défaillance permet de comparer les solutions, de préparer les licences et de vérifier la compatibilité des applications. La migration peut être organisée dans un créneau adapté, avec des sauvegardes et des contrôles de bon fonctionnement.
Le retrait de l’ancien matériel constitue une opération distincte. Il comprend notamment l’effacement sécurisé des données selon leur sensibilité et le support concerné, la désinscription des services de gestion et d’authentification, la récupération des licences lorsque leurs conditions l’autorisent et l’orientation vers une filière de réemploi ou de recyclage appropriée.
Pour vérifier que cette organisation produit les résultats recherchés, quelques indicateurs suffisent : incidents imprévus sur les équipements critiques, temps d’indisponibilité, opérations préventives réellement effectuées, interventions récurrentes et remplacements réalisés dans l’urgence. Leur évolution aide à supprimer les tâches sans bénéfice et à renforcer les contrôles utiles.
La prochaine action consiste à dresser l’inventaire des équipements critiques, à identifier les contrôles déjà réalisés et à programmer une première revue du calendrier. Cette démarche progressive permet d’améliorer la fiabilité informatique sans engager immédiatement un dispositif de maintenance disproportionné.
Une PME doit-elle disposer d’un logiciel spécialisé pour gérer sa maintenance préventive ?
Non. Un inventaire fiable, un calendrier partagé et un historique des interventions peuvent suffire pour un parc de taille modeste. Un logiciel spécialisé devient intéressant lorsque la diversité des équipements, le volume des opérations ou les exigences de traçabilité rendent le suivi manuel difficile. L’essentiel reste la qualité des informations et la régularité des décisions.
Quelle différence existe-t-il entre maintenance préventive et supervision informatique ?
La supervision collecte et analyse des informations sur l’état des équipements, des applications ou des services. La maintenance préventive comprend les actions destinées à limiter les défaillances, notamment les contrôles, les mises à jour et les remplacements planifiés. La supervision peut déclencher une intervention pertinente, mais une alerte ne justifie pas systématiquement une action immédiate.
Faut-il effectuer toutes les opérations de maintenance en dehors des heures de bureau ?
Non. Les contrôles sans impact sur la disponibilité peuvent souvent être réalisés pendant les horaires habituels. Les interventions nécessitant un redémarrage ou une interruption doivent être coordonnées avec les équipes concernées. Le créneau pertinent dépend des usages, des traitements automatisés et des possibilités de continuité de service, et pas seulement des horaires de présence.
Comment savoir si le programme de maintenance réduit réellement les pannes ?
Il faut comparer les incidents non planifiés, les durées d’interruption, les interventions urgentes et le temps consacré à la maintenance avant et après les ajustements. Ces indicateurs doivent être interprétés en tenant compte des changements du parc et de l’activité. Une baisse des incidents accompagnée d’une charge de maintenance maîtrisée constitue un signal favorable, sans prouver à elle seule une relation de causalité.
Peut-on confier la maintenance préventive à un prestataire externe sans perdre la maîtrise du parc ?
Oui, à condition de définir précisément les responsabilités, les équipements couverts, les modalités d’intervention, les comptes rendus attendus et les règles de validation des changements. L’entreprise doit conserver un accès à son inventaire, à ses configurations essentielles et aux informations nécessaires à la continuité d’activité. Les interventions externalisées doivent être évaluées selon les mêmes critères d’utilité et de risque que les opérations internes.